Cel mai bun model de embedding local pentru cod: am testat zece pe codul nostru
Îi ceri asistentului AI să schimbe felul în care se verifică autentificarea în proiectul tău. Lucrează un minut și îți arată, mulțumit, o modificare într-o funcție care nu are nicio legătură cu autentificarea. De cele mai multe ori nu a înțeles greșit ce i-ai cerut. A primit codul greșit.
Noi facem programul care îi dă asistentului codul. Se numește RagCode MCP și e gratuit. De curând ne-am dat seama că nu știam cât de bine își face treaba piesa lui cea mai importantă, pentru că nu o măsuraserăm niciodată. Articolul povestește cum am măsurat-o, ce am găsit și ce am schimbat.
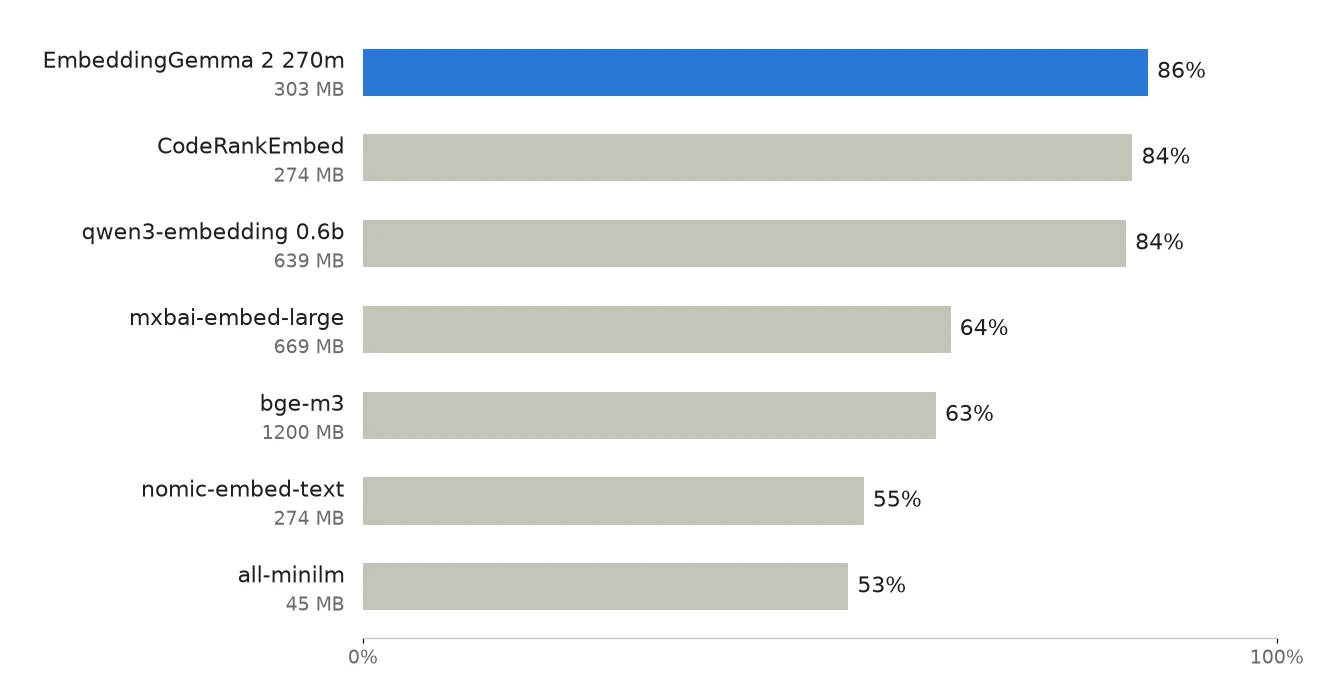
Pe scurt. Am pus zece modele AI mici, care rulează pe calculatorul tău, să caute în același cod. Cel mai bine a căutat EmbeddingGemma 2, de la Google: a găsit funcția potrivită în 86% din cazuri, față de 64% la modelul cu care am pornit RagCode. Ocupă jumătate din modelul pe care îl folosim azi.
De unde am pornit
Un asistent AI de programare nu poate citi un proiect întreg de fiecare dată când îi ceri ceva. RagCode caută în proiect bucățile de cod care au legătură cu cererea și i le dă doar pe acelea.
Căutarea nu merge după cuvinte, pentru că în funcția care verifică autentificarea s-ar putea să nu scrie nicăieri „autentificare”. Merge după înțeles, iar pentru asta RagCode folosește un model de embedding: un AI mic, care nu scrie nimic, ci doar citește o bucată de text și spune de care alte bucăți e aproape ca înțeles. Cum reușește, pe înțelesul oricui, am scris în articolul despre modelele de embedding.
Tot ce găsește sau nu găsește asistentul depinde deci de modelul acesta mic. Prima versiune de RagCode a pornit cu unul numit mxbai-embed-large. Versiunea 2, aflată acum în pre-release, folosește altul, qwen3-embedding, de la Alibaba1. Pe niciunul nu îl aleseserăm în urma unei măsurători.
De ce ne-am apucat de măsurat
Google a scos EmbeddingGemma 22, un model de două ori mai mic decât cel pe care îl folosim. Pentru noi, mărimea nu e un detaliu. RagCode rulează în întregime pe calculatorul programatorului, pentru că la multe firme codul nu are voie să plece nicăieri. Modelele le pornește prin Ollama3, un program gratuit care descarcă și rulează modele AI pe calculatorul tău. Mulți dintre cei care îl folosesc au un laptop fără placă video, iar acolo un model mai mic înseamnă mai puțină memorie ocupată și mai puțin timp de așteptare.
Întrebarea era simplă: trecem la modelul cel nou sau nu? Nu aveam cu ce răspunde. Știam că e mai mic. Nu știam dacă găsește codul la fel de bine, și nici cât de bine îl găsea cel de dinainte.
Cum afli dacă un model găsește codul
Ai nevoie de întrebări la care știi deja răspunsul. Clasamentele publice nu ajută, pentru că sunt făcute pe texte obișnuite, nu pe codul tău. Iar dacă scriam noi întrebările, le-am fi scris, fără să vrem, pe placul codului nostru.
Le-am luat din comentarii. În Go, limbajul în care e scris RagCode, aproape orice funcție are deasupra o propoziție care spune ce face. Propoziția a devenit întrebarea, iar funcția, răspunsul corect. Din întrebare am șters numele funcției și din cod am scos comentariile. Altfel modelul ar fi găsit întrebarea copiată în răspuns și n-am fi aflat nimic.
Au ieșit 2.054 de întrebări, puse pe 4.446 de funcții: tot codul RagCode și o parte din biblioteca standard a limbajului.4 Pentru fiecare model am numărat de câte ori funcția potrivită iese prima și de câte ori ajunge în primele cinci rezultate. A doua cifră contează mai mult, pentru că asistentul primește oricum mai multe rezultate și alege singur dintre ele.
Dacă tot făceam testul, n-am comparat doar două modele. Am luat zece, toate dintre cele care pot rula local: șase făcute pentru orice fel de text și patru antrenate special pe cod.
Ce a ieșit
| Model | Mărime | Iese prima | În primele cinci | În primele cinci, pe codul RagCode |
|---|---|---|---|---|
| EmbeddingGemma 2 (Google) | 303 MB | 57,5% | 85,9% | 89,0% |
| CodeRankEmbed (Nomic) | 274 MB | 58,1% | 84,2% | 81,2% |
| qwen3-embedding (Alibaba) | 639 MB | 53,9% | 83,5% | 76,3% |
| jina-embeddings-v2-base-code (Jina) | 322 MB | 50,8% | 79,1% | 74,3% |
| granite-embedding-english-r2 (IBM) | 299 MB | 40,3% | 68,7% | 60,8% |
| granite-embedding-small-english-r2 (IBM) | 97 MB | 36,2% | 64,5% | 55,5% |
| mxbai-embed-large | 669 MB | 37,2% | 64,3% | 57,1% |
| bge-m3 | 1,2 GB | 35,7% | 62,7% | 54,3% |
| nomic-embed-text | 274 MB | 29,9% | 54,8% | 42,9% |
| all-minilm | 45 MB | 25,7% | 53,1% | 48,2% |
Primele două coloane de cifre sunt pe toate întrebările. Ultima e doar pe cele 245 de întrebări despre codul RagCode, adică pe un proiect ca al oricărui programator, nu pe biblioteca pe care o știe toată lumea.
Modelul cel nou nu doar că ține pasul cu cel pe care îl folosim. Îl întrece, mai ales pe codul nostru: 89% față de 76%.
Trei lucruri la care nu ne așteptam
Modelul cu care am pornit era mult în urmă. mxbai-embed-large găsește funcția potrivită în primele cinci rezultate doar în două cazuri din trei. Un exemplu: în RagCode există o funcție care descarcă un model și afișează, pe un singur rând, cât s-a descărcat. Am întrebat de ea cu vorbele din comentariul ei. Primele trei modele din tabel au pus-o pe locul întâi. mxbai-embed-large nu a avut-o nici în primele zece rezultate, iar primul lui răspuns a fost o funcție care afișează mesaje de depanare.
Mărimea nu spune nimic. Cel mai mare model din test, bge-m3, are 1,2 GB și a ieșit printre ultimele. Primele două locuri au în jur de 300 MB fiecare.
Modelele făcute special pentru cod n-au câștigat. Ne așteptam să fie primele. Doar unul, CodeRankEmbed5, a ajuns în frunte, la egalitate cu EmbeddingGemma 2 pe tot testul și în urma lui pe codul nostru. În plus, niciunul dintre cele patru nu se poate instala direct prin Ollama. A trebuit să le convertim noi, cu un utilitar din llama.cpp6, iar unul dintre ele, cel de la Jina, a trecut prin conversie fără nicio eroare și dădea după aceea rezultate fără sens.
Ce am hotărât
Trecem la EmbeddingGemma 2. Găsește cel mai bine codul nostru, ocupă jumătate din qwen3 și e mai rapid pe un calculator fără placă video: 126 de funcții pe secundă la indexare, față de 104. Un proiect de 5.000 de funcții e gata în vreo 40 de secunde, o singură dată; după aceea se reface doar ce s-a schimbat.
CodeRankEmbed ar fi fost o alegere la fel de bună, și e chiar mai rapid, cu 205 funcții pe secundă. A pierdut dintr-un motiv practic. Cum nu se găsește în Ollama, ar fi trebuit să-l convertim noi și să-l dăm noi fiecărui om care instalează RagCode. EmbeddingGemma 2 se instalează cu o singură comandă, de la sursă.
Schimbarea are un preț: proiectul trebuie indexat din nou, pentru că rezultatele a două modele diferite nu se pot amesteca. RagCode face asta singur, la prima pornire cu modelul nou. Mai trebuie doar o versiune recentă de Ollama, 0.40 sau mai nouă.
Ce înseamnă asta pentru o firmă
Am folosit până acum modele pe care nu le măsuraserăm și am aflat abia la acest test că primul era slab. Testul care ne-a arătat asta s-a făcut într-o după-amiază. De aici vine singurul sfat din articol: un model nu se alege după ce scrie pe internet despre el, ci se încearcă pe ce ai tu, cu întrebări la care știi răspunsul.
Am măsurat doar cod Go, cu întrebări în engleză. Pe alt limbaj, ordinea din frunte poate ieși altfel, și tocmai de aceea merită repetat testul pe propriul proiect.
Același lucru e valabil în afara codului. Un sistem RAG pe documentele firmei caută în contracte și în proceduri exact cum caută RagCode în funcții, cu același fel de model. Acolo îl alegem la fel: cu câteva zeci de întrebări la care se știe răspunsul, puse pe documentele adevărate. Așa am comparat și modelele de transcriere în română.
Surse
-
Qwen3-Embedding-0.6B, Alibaba. ↩︎
-
EmbeddingGemma 2, fișa modelului, Google DeepMind. ↩︎
-
Ollama, programul cu care rulăm local modelele de embedding. ↩︎
-
Test propriu, 5 noiembrie 2026: 4.446 de funcții Go, 2.054 de întrebări, Ollama 0.40.14 în Docker, RTX 4060 Ti 16 GB, i9-14900K. Codul sursă RagCode e pe GitHub. ↩︎
-
CodeRankEmbed, Nomic. ↩︎
-
llama.cpp, proiect open source pentru rularea modelelor pe calculatoare obișnuite; de aici vine utilitarul de conversie. ↩︎
Întrebări frecvente
Care este cel mai bun model de embedding local pentru cod?
În testul nostru, pe 4.446 de funcții Go și 2.054 de întrebări, EmbeddingGemma 2 270m: funcția corectă a ajuns în primele cinci rezultate în 85,9% din cazuri, la 303 MB. CodeRankEmbed a ieșit la egalitate pe tot corpusul, dar mai slab pe codul nostru și nu se găsește în Ollama.
Ce este Ollama?
Un program gratuit care descarcă și rulează modele AI pe calculatorul tău, cu o singură comandă pe model. RagCode MCP îl folosește pentru calculul vectorilor, deci codul nu pleacă de pe calculator.
Trebuie să reindexez proiectul dacă schimb modelul?
Da. Fiecare model desenează altă hartă, iar vectorii vechi nu înseamnă nimic pe harta nouă. RagCode face asta singur la prima pornire cu modelul nou.