Cum ajunge un asistent AI să răspundă din documentele tale: ce este un model de embedding
Firma ta are 2.000 de contracte într-un folder. Vrei să întrebi un asistent AI, cum e ChatGPT: „În cât timp putem rezilia contractul cu furnizorul de curent?” Asistentul nu a citit niciodată contractele tale, deci nu le cunoaște. Nici nu i le poți da pe toate odată: un asistent poate citi doar o cantitate limitată de text la o întrebare, iar 2.000 de contracte o depășesc cu mult. Totuși există asistenți AI care răspund la asemenea întrebări din documentele tale și îți arată și pagina din care au luat răspunsul. Nu reușesc singuri. Înainte ca asistentul să răspundă, un program mult mai mic caută paginile potrivite, iar asistentul le citește doar pe acelea.
Articolul acesta e despre programul acela mic și despre căutarea pe care o face. Specialiștii îi spun model de embedding, iar întregii metode, RAG. Sunt două denumiri englezești pe care le auzi tot mai des și pe care le explicăm pe rând. La sfârșit o să știi ce înseamnă și de ce un astfel de asistent răspunde uneori greșit, cu toată siguranța. Nu ai nevoie de cunoștințe tehnice.
Asistentul nu ți-a citit documentele
Un asistent AI a învățat din texte publice: cărți, articole, pagini de internet. Contractele tale, procedurile firmei și e-mailurile nu erau printre ele. Ca să răspundă din ele, trebuie să i le dai odată cu întrebarea.
Și trebuie să i le dai de fiecare dată, pentru că asistentul nu ține minte nimic de la o întrebare la alta. La fiecare întrebare citește de la capăt tot ce primește: întrebarea ta, mesajele de mai devreme din conversație și documentele pe care i le-ai dat. Tot acest text se numește context. E ca un dosar pus pe biroul cuiva care răspunde numai din ce găsește în el. Am povestit pe larg despre dosar în articolul despre memoria AI.
Dosarul nu poate fi oricât de gros. Fiecare asistent are o mărime maximă a contextului, de la câteva sute la câteva mii de pagini, în funcție de asistent. Un contract de zece pagini încape fără probleme. Două mii de contracte înseamnă zeci de mii de pagini și nu încap la niciunul. Iar chiar și când un text mare încape, un context plin nu e o soluție bună. Asistentul îl recitește întreg la fiecare întrebare, deci răspunde mai încet. Răspunde și mai slab: cu cât are mai mult de citit, cu atât îi scapă mai ușor tocmai rândul care conta, mai ales când rândul acela e undeva pe la mijloc. Și costă mai mult: un asistent folosit într-o firmă se plătește, de regulă, după cât text citește și scrie.
Deci cineva trebuie să aleagă, înaintea asistentului, cele câteva pagini care contează pentru întrebarea ta. Tot ce urmează e despre cum se face alegerea asta.
De ce nu ajunge să cauți cuvintele
Prima idee e să cauți în contracte cuvântul „rezilia”. Numai că în contract scrie „încetarea contractului înainte de termen se face cu un preaviz de 30 de zile”. Întrebarea și răspunsul nu au niciun cuvânt important în comun. Căutarea după cuvinte găsește ce ai scris, nu ce ai vrut să spui.
Ai văzut deja problema rezolvată. Scrii pe Google „mă doare capul după cafea” și primești pagini despre „cefalee și cofeină”. Niciun cuvânt din cele căutate nu apare în ele, și totuși ai primit ce căutai.
O hartă în loc de dicționar
Calculatorul nu înțelege cuvinte. Pentru el, „reziliere” și „încetare” sunt două șiruri de litere diferite, la fel de străine unul de altul ca „reziliere” și „salată”. Ce știe să facă foarte bine e să compare numere. Toată ideea e deci să transformăm înțelesul unui text în numere.
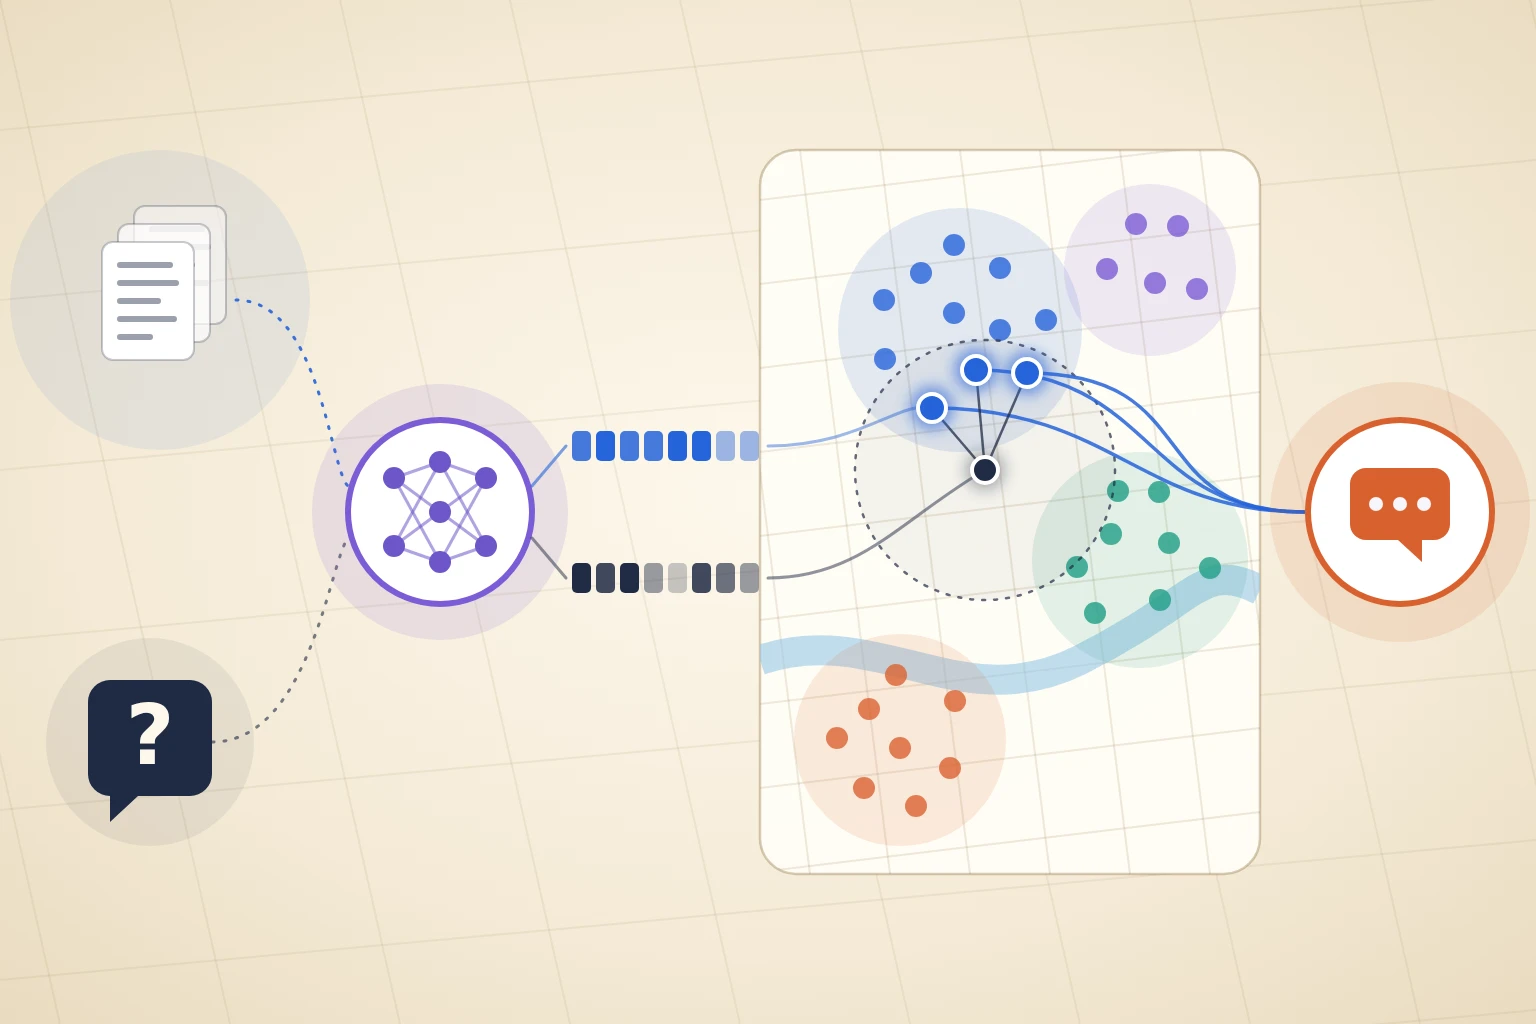
Cel mai ușor e să ne închipuim o hartă. Pe o hartă obișnuită, orașele apropiate stau aproape: Ploieștiul e lângă Câmpina și departe de Timișoara. Pe harta noastră, în loc de orașe sunt texte, iar aproape unul de altul stau textele care vorbesc despre același lucru. Într-un cartier s-au strâns toate fragmentele despre încheierea unui contract: „reziliere”, „încetarea înainte de termen”, „preaviz de 30 de zile”. În alt cartier stau cele despre plăți: „factură”, „scadență”, „penalități de întârziere”. Și mai departe, cele despre concedii.
Pe hartă, un oraș are o adresă făcută din două numere, latitudinea și longitudinea. Dacă știi numerele a două orașe, poți calcula distanța dintre ele fără să te uiți la hartă. La fel primește și fiecare text o adresă făcută din numere. Numai că înțelesul are mult mai multe direcții decât nord-sud și est-vest, așa că adresa unui text are câteva sute de numere, nu două. O asemenea hartă nu se poate desena pe hârtie, dar calculatorul nu are nevoie s-o vadă. Îi ajung numerele ca să calculeze cât de departe e un text de altul.
Cine dă adresele? Tot un AI. E rudă cu cele care scriu răspunsurile în ChatGPT, dar mult mai mic și cu o singură specializare: nu scrie nimic, doar citește un text și îi calculează adresa. A învățat să facă asta citind biblioteci întregi și reținând un singur lucru: cu ce cuvinte se însoțește fiecare cuvânt. E vorba veche, „spune-mi cu cine te însoțești ca să-ți spun cine ești”. „Reziliere” și „încetarea contractului” apar în aceleași fraze, lângă „preaviz”, „notificare” și „părți”, deci primesc adrese apropiate. La fel ajunge „cefaleea” lângă „durerea de cap”. Nimeni nu i-a explicat programului ce e un contract sau o durere de cap. Nu înțelege ce citește, dar știe ce texte seamănă între ele.
De aici, căutarea e simplă. Întrebarea ta, „În cât timp putem rezilia contractul cu furnizorul de curent?”, primește și ea o adresă. Calculatorul nu mai caută cuvântul „rezilia”. Se uită ce fragmente stau cel mai aproape de întrebare și le găsește pe cele despre încetarea contractului, deși nu au niciun cuvânt important în comun cu ea.
În limbaj tehnic, adresa făcută din numere se numește vector, iar programul care o calculează, model de embedding. „Model” e numele obișnuit pentru un program AI, iar „embedding” se folosește netradus și în română.
Ce se întâmplă când pui o întrebare
Sunt două momente diferite.
O singură dată, la început. Documentele tale sunt tăiate în fragmente: un articol de contract, un paragraf dintr-o procedură, un e-mail. Modelul de embedding îi dă fiecărui fragment un loc pe hartă.
La fiecare întrebare.
- Întrebarea ta primește și ea un loc pe hartă.
- Calculatorul ia fragmentele care stau cel mai aproape de ea, de obicei câteva.
- Le pune în dosar, lângă întrebare.
- Asistentul scrie răspunsul din ele și îți poate arăta din ce document le-a luat.
Tehnica se numește RAG, prescurtarea de la „retrieval-augmented generation”. În română circulă traducerea „generare augmentată prin regăsire”. Pe scurt: întâi cauți, apoi scrii. Fără ea, un asistent poate discuta doar cu documentele care încap întregi în context. Cu ea, poate răspunde dintr-o arhivă întreagă.
Unde se strică
Asistentul răspunde din ce primește. Dacă harta îi aduce fragmentele greșite, răspunsul iese la fel de bine scris și la fel de sigur, dar greșit. În text nu apare niciun semn care să te avertizeze. De aceea contează cine desenează harta.
Am măsurat asta pe un caz al nostru. Programatorii, oamenii care scriu programe de calculator, au aceeași problemă ca firma cu contractele. Un program este tot text: mii de rânduri, numite cod, împărțite în bucăți care fac fiecare câte un lucru. Programatorii lucrează azi cu asistenți AI care îi ajută să scrie cod, iar asistentul trebuie să găsească, în tot programul, bucata despre care e vorba. Pentru asta am făcut RagCode MCP, un program gratuit, cu codul public, care îi aduce asistentului bucata potrivită, exact cum am descris mai sus.
Modele de embedding sunt de două feluri. Unele stau în cloud, la firma care le-a făcut: fiecare text pe care vrei să-l așezi pe hartă pleacă la ea prin internet și se plătește după cantitate. Altele se pot descărca și rula pe calculatorul tău, fără ca vreun text să plece undeva și fără plată la fiecare folosire. Noi am testat doar modele din al doilea fel și le-am rulat pe toate local, pe calculatorul nostru.
Am pus zece asemenea modele să deseneze harta aceluiași program și am numărat de câte ori ajunge bucata potrivită printre primele cinci rezultate. Cel mai bun pe codul nostru a fost EmbeddingGemma 2, un model făcut de Google și oferit gratuit: a reușit la aproape nouă întrebări din zece, iar modelul cu care pornisem, la două din trei.
Rulează pe un calculator obișnuit, fără internet, deci documentele nu pleacă nicăieri ca să fie așezate pe hartă. Și e mic: ocupă 303 MB, de două ori mai puțin decât modelul pe care îl înlocuiește la noi. Pentru programatori, cifrele și felul în care am măsurat sunt în articolul despre test.
Înapoi la cele 2.000 de contracte
Acum poți urmări ce se întâmplă cu întrebarea de la început. Contractele firmei sunt așezate pe hartă o singură dată, de un model de embedding care rulează pe un calculator din birou. Tu întrebi: „În cât timp putem rezilia contractul cu furnizorul de curent?” Căutarea găsește articolul despre încetarea înainte de termen, deși în el nu scrie nicăieri „reziliere”. Asistentul primește articolul acela și încă vreo câteva fragmente și îți răspunde: 30 de zile, cu trimitere la pagina din contract.
Pentru asta nu mai e nevoie de o companie mare și de un buget pe măsură, și nici ca arhiva să plece din firmă. Există soluții locale: modelul de embedding e mic, e gratuit și merge pe un calculator obișnuit, iar asistentul vede doar cele câteva fragmente de care are nevoie pentru o întrebare.
Ce nu e realist e să-ți pui singur la punct așa ceva. Modelul de embedding e o singură piesă. Trebuie ales și instalat, documentele trebuie tăiate în fragmente și așezate pe hartă, iar căutarea trebuie legată de asistent și verificată cu întrebări la care se știe răspunsul. E muncă de programator, cam ca instalarea unui program de contabilitate: o face o firmă de software, iar tu apoi doar îl folosești. Noi am făcut-o întâi pentru codul nostru și o facem și pentru documentele altor firme.
Mai rămâne un lucru de ținut minte, oricine ți-ar vinde un asemenea asistent. Răspunsul lui e cel mult la fel de bun ca pagina pe care a primit-o. De aceea un asistent făcut cum trebuie îți arată de fiecare dată pagina din care a răspuns, iar tu o poți deschide și citi.
Surse
- Cel mai bun model de embedding local pentru cod: măsurătorile noastre pe codul RagCode MCP.
- Studiu de caz: RagCode MCP și codul sursă pe GitHub.
- Memoria AI: ce ține minte ChatGPT: de ce asistentul nu poate citi oricât odată.
- Lost in the Middle: How Language Models Use Long Contexts, Liu și colaboratorii, 2023: asistenții folosesc mai prost informația aflată la mijlocul unui context lung.
Întrebări frecvente
Ce este un model de embedding?
Un program care transformă un text într-o listă de numere, astfel încât două texte cu același înțeles primesc liste apropiate. Lista se numește vector. Căutarea semantică înseamnă să găsești textele ai căror vectori stau cel mai aproape de vectorul întrebării.
Ce este RAG?
Retrieval-augmented generation: întâi cauți, apoi scrii. Documentele sunt transformate o singură dată în vectori. La fiecare întrebare, asistentul AI primește doar fragmentele cele mai apropiate de ea și răspunde din ele. Așa poate lucra cu o arhivă care nu ar încăpea întreagă în contextul lui.
De ce răspunde greșit un asistent AI care are acces la documentele mele?
De cele mai multe ori pentru că n-a primit fragmentul potrivit. Asistentul răspunde din cele câteva fragmente pe care le-a primit odată cu întrebarea. Dacă acolo nu e pagina care trebuie, scrie un răspuns la fel de sigur, dar greșit.