De ce inventează AI-ul când scrie articole și cum l-am oprit în Din lume
Dacă ai cerut vreodată unui asistent AI să-ți spună ce s-a întâmplat ieri în lume, știi cum arată răspunsul: fluent, sigur pe el, cu nume și cifre. Și, din când în când, greșit. Papa Francisc dat drept Papă în funcție la săptămâni după moarte, un raport cu cifre care nu există, o declarație pe care nimeni n-a făcut-o. Într-un studiu al televiziunilor publice europene, 45% din răspunsurile asistenților AI despre știri aveau cel puțin o problemă semnificativă.1 Modelul nu minte. Nu știe că nu știe.
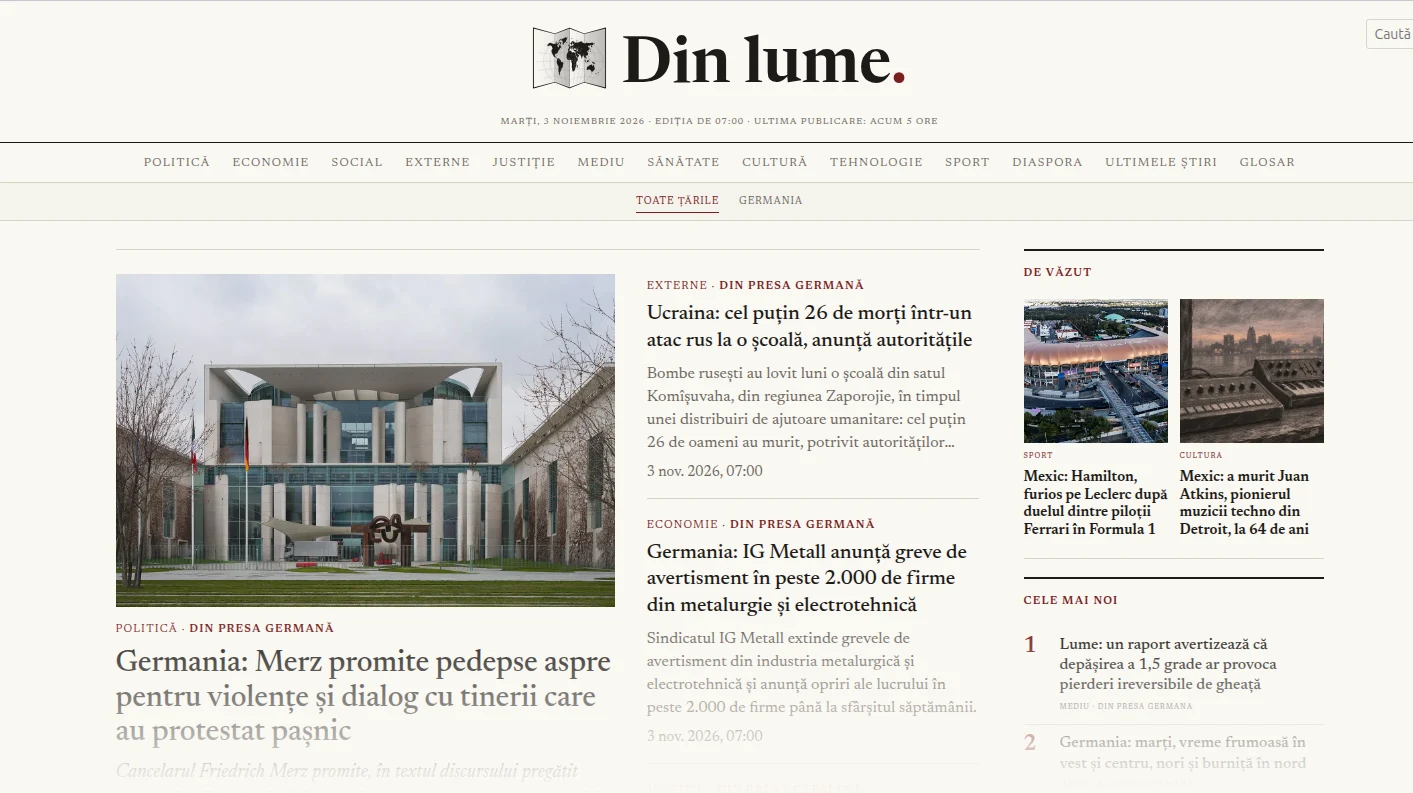
Noi am pornit de la întrebarea inversă: se poate construi un ziar scris integral de agenți AI care să nu facă asta? Nu un experiment de o zi, ci un ziar adevărat, cu ediții la ore fixe, din presa unei alte țări, în română, pe care să-l citești dimineața cu cafeaua. Ziarul se numește Din lume și a apărut în 31 de ediții, din 16 octombrie până pe 3 noiembrie 2026. Articolul ăsta spune ce am învățat despre felul în care greșește AI-ul când scrie știri: cum inventează, cum ia partea cuiva fără să vrea, cum ajunge să judece în loc să relateze și cum sună româna lui. Ce a ieșit, cu cifre, după aproape 900 de articole, e în articolul următor.
Pe scurt: jumătate din articolele noi de pe internet sunt scrise de AI, iar doar 12% din public se simte confortabil cu știri făcute integral de AI. Un model de limbaj lăsat singur inventează, preia tonul unei singure surse, judecă în locul cititorului și scrie o română tradusă în mod discutabil. Niciuna din problemele astea nu se rezolvă cu un simplu prompt. Din lume, ziarul nostru scris de agenți AI, le-a întâlnit pe toate; aici povestim cum arată fiecare problemă și ce regulă a ieșit din ea. Rezultatul măsurat, 0,12% halucinații după 886 de articole, e în articolul următor. E meritul regulilor, al „hamului” construit în jurul modelelor: reguli scrise înainte și verificări făcute după, de altcineva. Hamul înseamnă muncă și tehnică, nu doar un prompt bine scris.
Jumătate din internet e scris deja de AI
Întâi cifrele mari, ca să știm unde suntem.
În primul trimestru din 2026, 49,9% din articolele noi publicate pe web în engleză erau scrise preponderent de AI. Cifra vine din studiul Graphite, care a trecut 55.400 de articole din arhiva Common Crawl prin trei detectoare de text AI și a luat media.2 În ultimul trimestru din 2025, articolele AI le depășiseră pe cele scrise de oameni, pentru prima dată. Pew Research Center, cu altă metodă și pe aproape 490.000 de pagini, găsește semne de autor AI pe una din zece pagini din eșantionul din iulie 2026 și pe mai mult de o treime din paginile cu dată de publicare de după lansarea ChatGPT.3
În presă e mai puțin, dar nu puțin. O echipă de cercetători a analizat 186.000 de articole din edițiile online a 1.500 de ziare americane, din vara lui 2025: aproximativ 9% erau parțial sau integral scrise de AI. Din 100 de articole semnalate și verificate manual, doar 5 declarau că au folosit AI.4
Și apoi e partea întunecată. NewsGuard, o firmă care evaluează credibilitatea site-urilor de știri, număra la 23 iunie 2026 3.749 de „ferme de conținut AI”: site-uri care arată ca niște ziare, publică texte făcute în mare parte de AI, fără supraveghere umană, și nu spun asta nicăieri. În 16 limbi.5 Pentru lucrurile astea s-a încetățenit un cuvânt: slop, în traducere liberă „lături”. Texte și clipuri generice, la fel peste tot, făcute ca să umple un spațiu și să prindă un clic, nu ca să spună cuiva ceva. Nu e doar text: într-un test cu date din octombrie 2025, 59% din primele 500 de clipuri pe care TikTok le-a arătat unui cont nou-nouț erau făcute cu AI; pe YouTube Shorts, 21%. Testul măsoară ce servește algoritmul unui cont nou, nu cât se încarcă în total, și e făcut de o firmă de editare video, deci îl luăm ca indiciu, nu ca recensământ.6
Publicul simte asta. Reuters Institute, de la Universitatea Oxford, a întrebat la sfârșitul verii 2026 câte 2.000 de oameni din nouă țări: 38% folosiseră AI ca să se informeze în ultima săptămână, de peste trei ori mai mulți decât în 2024. Dar doar 12% se simt confortabil cu știri făcute integral de AI. Cu știri făcute integral de un jurnalist, 67%.7 Încrederea în știri, în general, e la 37%, cea mai scăzută de când o măsoară Reuters Institute, din 2015.8
Deci asta e piața în care intră un ziar scris de AI: jumătate din ce se publică e AI, doar 12% din public se simte confortabil cu el, iar Google tratează fermele de conținut ca spam, cum arătăm în articolul următor. Nu e un loc bun de pornit. Tocmai de aceea am vrut să vedem dacă se poate altfel.
Ce este, de fapt, o halucinație
Un model de limbaj, programul din spatele ChatGPT, Claude sau Gemini, a învățat dintr-o cantitate uriașă de text cum se continuă o frază. Când îi pui o întrebare, nu caută răspunsul într-o bază de date. Produce textul cel mai probabil, cuvânt cu cuvânt. De cele mai multe ori textul probabil e și adevărat, pentru că a fost scris de multe ori de oameni care știau. Când nu e, modelul nu are de unde să afle. Scrie mai departe, cu aceeași siguranță. Asta se numește halucinație.9
În presă, halucinația are trepte. Pe prima, modelul rotunjește: „peste 100 de polițiști răniți” devine „100”, „o estimare” devine „un fapt”. Pe a doua, adaugă legături pe care sursele nu le fac: „ceea ce arată că”, „de aceea”, o concluzie în locul cititorului. Pe a treia, inventează de-a dreptul: o cifră, un citat, o declarație, un raport cu titlu și dată. Și, la capăt, inventează știrea întreagă, cu sursa ei cu tot. Avocații unui reclamant din Statele Unite au fost sancționați în 2023 pentru că au depus în instanță decizii judecătorești pe care ChatGPT le inventase, cu citate și trimiteri cu tot.10
Prima tentație e să scrii în prompt, adică în instrucțiunile pe care i le dai modelului: „nu inventa”. Nu ajută, pentru că modelul nu știe când inventează. Aceeași mecanică produce și adevărul, și invenția. Regula „nu inventa” e citită de același mecanism care inventează.
Am învățat asta pe pielea noastră. Pe 16 octombrie, o „sursă” ilizibilă, fără niciun cuvânt în ea, a ajuns în fața agentului care scrie. Nu s-a publicat nimic din ea, dar ne-a arătat ce înseamnă „sursa există” fără să verifici și ce e în ea. Pe 17 octombrie, harta de lângă un articol arăta Germania la un fapt petrecut în Oregon: locul fusese dedus din țara ziarului, nu citit din text. Iar pe 13 octombrie, într-o rulare de test, am avut o ediție cu 19 articole scrise și 0 publicate, pentru că verificatorul respingea orice articol cu o singură afirmație neconfirmată, oricât de măruntă. De atunci regula e alta: afirmația neconfirmată iese din text, articolul rămâne.
Principiul la care am ajuns e simplu de spus și greu de construit: agentul scrie numai din texte pe care le are în față, nu din ce „știe”; tot ce nu se confirmă într-o sursă iese din articol; iar citatele și adresele se verifică de ceva care nu e un model. Pentru cititor, rezultatul e că fiecare articol de pe Din lume are la final lista surselor, iar sursele există și duc unde spun.
Cifrele din producție arată cât de des e nevoie de asta. Din 886 de articole pornite, 801 au fost scrise și au trecut prin verificator. În ele, verificatorul a trecut prin 13.384 de afirmații, una câte una. 129 n-au putut fi confirmate și au fost scoase înainte de publicare. 100 dintre ele erau susținute doar de un tabloid german, pe care noi îl tratăm ca „voce”: o publicație care poate fi citată pentru ce spune ea, dar nu poate susține singură un fapt.
Tonul unei singure surse
A doua problemă e mai subtilă decât inventatul și n-am găsit niciun studiu despre ea, așa că vorbim din experiența noastră.
Un agent care scrie din trei surse nu le amestecă în mod egal. Ia tonul uneia, de obicei a celei mai lungi sau a celei mai bine scrise, și o parafrazează. Pe 17 octombrie am măsurat cât de aproape ca sens sunt articolele noastre de sursele din care au fost scrise, cu o măsură de la 0 la 1, în care 1 înseamnă același conținut. Media era acceptabilă, 0,77. Dar o frază dintr-un articol DPA, agenția de presă germană, era redată aproape literal, cu 0,89. Nu era plagiat în sensul obișnuit. Era ceva mai rău pentru un ziar: un singur unghi, prezentat ca al nostru.
Paradoxul e că și opusul strică. Când i-am cerut verificatorului să atribuie totul, a pus „potrivit X” în aproape fiecare frază. Cititorii s-au plâns de ritmul sacadat. Am măsurat: în unele articole, 76% din fraze numeau o publicație. Acum sunt între 0 și 19%, iar publicația apare doar când ea e autorul afirmației, nu când preia o agenție.
Aici e și capcana agențiilor de presă. O informație DPA apare în zece ziare germane, cu zece titluri diferite. Pentru un model, sunt zece surse. Pentru un ziar, e una. Pe 18 octombrie, într-o singură ediție, 8 articole au fost oprite pentru că „sursele independente” erau de fapt aceeași informație relatată în ziare diferite. La fel cu grupurile de presă: Handelsblatt și Tagesspiegel aparțin DvH Medien, a familiei von Holtzbrinck, care deține și jumătate din Die Zeit. Le numărăm ca o singură sursă; fără confirmare din alt grup, știrea nu se scrie.
Soluția noastră e editorială, nu tehnică, și o spunem ca principiu: fiecare subiect se scrie din surse de la stânga la dreapta și din presa publică; un grup de presă contează o singură dată; o agenție preluată de zece ziare e o singură voce. În articolele publicate, media e de 5,7 surse utilizabile pe articol, din 5,4 grupuri de presă diferite. Am scos din listă publicațiile care interzic citarea în condițiile lor de utilizare, printre care Der Spiegel și manager magazin în Germania, Adnkronos, LaPresse și Domani în Italia. Nu pentru că ar fi rele. Pentru că nu putem cita pe cineva care spune că nu vrea.
De ce nu ajunge să scrii în prompt „fii echilibrat”? Pentru că modelele au înclinări proprii. Un studiu din 2024, pe rezumatele a 20.344 de articole de știri despre cinci teme politice, a găsit la mai multe modele o înclinare consecventă spre Partidul Democrat american; un altul, din 2026, pe 13 modele, a arătat că instrucțiunile de echilibrare funcționează la unele și la altele nu.11 Echilibrul trebuie construit în ce primește modelul, nu cerut în ce i se spune.
Coloana vertebrală: relatează, nu judecă
A treia problemă e că modelul vrea să fie deștept. Nu îi ajunge să spună ce s-a întâmplat; vrea să spună și ce înseamnă.
Pe 19 octombrie, într-un articol despre două partide germane care se apropiau, agentul care scrie a pus un intertitlu: „BSW se distanțează, dar nu de tot”. Nicio sursă nu spunea asta. Era concluzia lui. În același articol, vorbele unui singur participant ajunseseră titlu de secțiune, ca și cum ar fi fost un fapt. Verificatorul le lăsase să treacă. Regulile existau, dar agentul trebuia să le caute singur. Am numărat: nu le căutase în 178 de sesiuni. Le-am mutat acolo unde nu le poate ocoli.
Din producție: 239 de fraze-concluzie fără sursă scoase de verificator din articole, 44 de etichete politice corectate: „Bild” devenise „tabloidul conservator Bild”, fără ca vreo sursă din articol să-l numească așa. Mai sunt și micile tipare preferate de AI: „Vestea contează și politic:”, „și nimeni nu spune asta” sau „Aeroportul a mai fost în știri.” Fraze goale, pe care un om nu le-ar scrie.
Judecata apare și unde nu te aștepți: la alegerea subiectelor. Tot pe 19 octombrie, ședința de redacție a agenților a renunțat la o știre despre Cindy Crawford și la una despre proteste la Milano, pe motiv că „nu-i privește pe oamenii din Germania”. Un agent care trebuia să verifice doar siguranța textului refuza un articol de cultură pentru că i se părea „monden”. Regula care a ieșit de aici e una pe care ar trebui s-o respecte orice redacție: un agent nu refuză un subiect pentru că nu-i place. Etichetele politice și morale se atribuie cuiva (citate) sau ies.
Cât de bine ține regula asta? Auditul independent, descris în articolul următor, a găsit, în 60 de articole, o singură judecată a redacției prezentată ca fapt: „NIUS, portal de dreapta”, fără sursă în acel articol. Și 12 etichete de orientare sau de tip ale publicațiilor („post public”, „liberal-conservator”) care vin din lista noastră de publicații, nu din sursele citate.
Româna
Despre limbă am scris pe larg în articolul despre skillul „romana”, skillul nostru open source. Aici doar ce ține de ziar.
Sursele sunt în germană, iar româna agenților suna tradusă. Pe 17 octombrie, un titlu avea „alarmă falsă în gări din trei landuri”, cu topica germană. Corecturile redactorului uman, făcute de mână în primele zile, au devenit reguli: „esteni” nu există, se spune „cei din est”; „socializare”, pentru „Vergesellschaftung”, e un calc, iar sensul e „expropriere” sau „trecere în proprietate publică”; „medica” nu e cuvânt; „flux de numerar liber” e „flux de numerar disponibil”.
Verificatorul face și el corecturi de limbă: 4.824 în cele 801 articole, dintre care 501 pentru „sunet de traducere”, 360 pentru calcuri și 285 pentru termeni lăsați netraduși. „Partid popular”, pentru „Volkspartei”, a devenit „partid cu o bază electorală largă”.
Dar o corectură poate strica sensul. Pe 21 octombrie, un articol despre un produs retras de pe piață pentru risc de listerie a fost corectat în „salmonelă”. Altă bacterie. A fost corectat din nou, în „listerioză”. Regula care a rezultat: o corectură de limbă nu schimbă niciodată agentul patogen, cifra sau numele din sursă. Corectura se verifică din nou față de sursă, ca orice altă afirmație.
Ce urmează
Toate regulile de mai sus au fost scrise după câte o greșeală reală și apoi puse în jurul modelelor, nu cerute de la ele. Ce a ieșit, cum lucrează împreună trei familii de modele, ce face omul la capăt, ce spune Google despre conținutul AI și cum am măsurat rata halucinațiilor, e în a doua parte: Din lume, ziarul nostru scris de agenți AI.
Surse
-
AI’s systemic distortion of news is consistent across languages and territories, European Broadcasting Union, 22 octombrie 2025: 22 de organizații media publice din 18 țări, 14 limbi, peste 3.000 de răspunsuri de la ChatGPT, Copilot, Gemini și Perplexity, studiu coordonat de EBU și condus de BBC. Exemplul cu Papa e din relatarea AFP despre studiu, preluată de RNZ, 22 octombrie 2025: întrebările au fost puse între sfârșitul lui mai și începutul lui iunie 2025, iar trei din patru asistenți l-au numit pe Francisc drept Papă în funcție. ↩︎
-
AI Now Writes as Many Online Articles as Humans, Graphite, 15 mai 2026: 55.400 de articole în engleză din Common Crawl, ianuarie 2020 – martie 2026, trei detectoare (Pangram, Copyleaks, GPTZero). „Preponderent AI” înseamnă că, după regula fiecărui detector, partea estimată ca AI o depășește pe cea umană. ↩︎
-
How Much of the Internet Is Written With AI?, Pew Research Center, 20 august 2026: 490.000 de pagini în engleză, câte 10.000 din fiecare dintre cele 49 de instantanee Common Crawl din ianuarie 2021 până în iulie 2026, detectorul Open Pangram. Cifra de o treime e pe paginile cu dată de publicare detectabilă, adică 10–15% din eșantion. Metodologia. ↩︎
-
Jenna Russell, Marzena Karpinska, Destiny Akinode, Katherine Thai, Bradley Emi, Max Spero, Mohit Iyyer, AI use in American newspapers is widespread, uneven, and rarely disclosed, arXiv, versiunea din 26 aprilie 2026 (versiunea pentru ACL). ↩︎
-
AI Tracking Center, NewsGuard, actualizat la 23 iunie 2026. Un site intră în listă dacă o parte substanțială a conținutului e produsă de AI, fără supraveghere umană semnificativă, e prezentat ca și cum ar fi scris de oameni și nu declară AI-ul. ↩︎
-
55 AI-Generated Video Statistics, Kapwing, pagină actualizată în iunie 2026, cu date din octombrie 2025. Kapwing e o firmă de editare video. ↩︎
-
Generative AI and News Report 2026, Reuters Institute for the Study of Journalism, 29 octombrie 2026: nouă țări, aproximativ 2.000 de respondenți pe țară, teren 14 august – 28 septembrie 2026. Cifra de 38% e pe cele șase țări cu date din 2024. ↩︎
-
Digital News Report 2026, Reuters Institute, iunie 2026: 97.520 de respondenți din 48 de piețe. ↩︎
-
Hallucination (artificial intelligence), Wikipedia. ↩︎
-
Mata v. Avianca, Wikipedia: cazul din 2023 în care avocații reclamantului au fost sancționați cu 5.000 de dolari pentru decizii inventate de ChatGPT, cu citate și trimiteri fabricate. ↩︎
-
Supriti Vijay, Aman Priyanshu, Ashique R. KhudaBukhsh, When Neutral Summaries are not that Neutral: Quantifying Political Neutrality in LLM-Generated News Summaries, arXiv, octombrie 2024: 20.344 de articole pe cinci teme (avort, arme, sănătate, imigrație, drepturi LGBTQ+); Nannan Huang, Iffat Maab, Junichi Yamagishi, When Bigger Isn’t Better: A Comprehensive Fairness Evaluation of Political Bias in Multi-News Summarisation, ACL 2026: 13 modele, „prompt-based debiasing proves highly model dependent”. ↩︎
Întrebări frecvente
De ce inventează ChatGPT și ceilalți asistenți AI informații?
Pentru că un model de limbaj nu caută adevărul, ci continuarea cea mai probabilă a unui text. Când nu știe, nu tace: scrie ce sună plauzibil, cu aceeași siguranță ca atunci când știe. Fenomenul se numește halucinație. Nu dispare cu un prompt mai bun; scade mult doar dacă modelul e obligat să scrie numai din texte pe care le are în față și dacă altcineva verifică fiecare afirmație.
Cum verific dacă ce îmi spune un AI e adevărat?
Cere sursa și deschide-o. Dacă sursa nu există, nu se deschide sau nu spune ce susține AI-ul, afirmația nu are acoperire. Pentru cifre, nume și date, caută documentul original, nu un rezumat. Dacă nu ai timp să verifici, tratează răspunsul ca pe o părere, nu ca pe un fapt.
Cât de des greșesc asistenții AI la știri?
Studiul EBU și BBC din octombrie 2025, pe peste 3.000 de răspunsuri de la ChatGPT, Copilot, Gemini și Perplexity, în 14 limbi: 45% din răspunsuri aveau cel puțin o problemă semnificativă, 31% aveau probleme serioase de surse, iar 20% probleme majore de acuratețe, inclusiv detalii halucinate și informații depășite.
Ce înseamnă „a ține un agent AI în hamuri”?
Să construiești în jurul modelului tot ce îl ține pe o anumită cale spre atingerea unui scop: reguli scrise înainte, care îi spun ce nu are voie, și verificări după, făcute de un program sau de alt model, care prind când a greșit. Modelul nu decide singur ce e adevărat, ce e important și ce se publică.